김영신 medicalkorea1@daum.net
실제 진료현장에서 대형언어모델(LLM)을 활용할 수 있는 구체적 방안이 제시됐다.
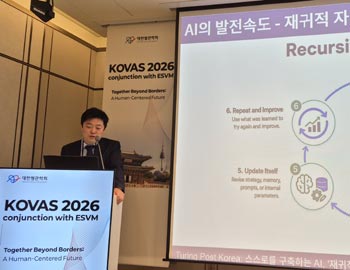
용인세브란스병원 심장내과 배성아 교수는 지난 17일 서울 그랜드인터컨티넨탈 파르나스에서 열린 국제학술대회 ‘KOVAS 2026’(대한혈관학회·유럽혈관의학회 공동개최) 세션14 강연에서 LLM이 기존 심혈관 위험도 예측 공식과 동등한 성능을 보이는 동시에 복잡한 진단 사례에서는 인간 전문가를 능가한다는 연구 결과와 함께 이같은 방안들을 발표했다.
◆회귀식 대체하는 LLM
그동안 심혈관질환 위험 예측은 프래밍험, ACC/AHA 통합코호트 점수 등 고정된 변수를 활용한 회귀식에 의존해왔다.
배 교수팀은 GPT-4 기반 심혈관 위험 예측모델을 UK바이오뱅크(4만 7,468명)와 한국인유전체역학조사사업(KoGES, 5,718명) 데이터로 검증했다.
UK바이오뱅크 코호트에서 AUROC(곡선하면적) 0.725를 기록해 ACC/AHA(0.733), 프래밍험(0.728) 점수와 유사한 수준을 보였고, 상관계수는 0.882(p<0.001)로 강한 일치도를 나타냈다.</p>
◆진단 정확도 높아져
배 교수는 예측을 넘어선 임상적 추론 능력도 소개했다.
메드스케이프의 사례 챌린지 1426건을 분석한 결과 o1-프리뷰 모델은 93.7%의 정확도를 기록해 인간 전문가(85.0%, p<0.001)를 웃돌았으며, 반복 평가에서도 89.6%의 일관성을 유지했다. </p>
텍스트와 이미지를 함께 입력한 GPT-4 옴니는 88%의 정확도로, 텍스트 단독(87%)보다 조금 높았다.
◆실제 진료현장서 검사·비용 감소 효과 확인
다기관 무작위대조군 연구인 ‘AI-게이트키퍼’ 시험(450명 대상)에서는 관상동맥질환 의심 환자를 대상으로 AI 보조 선별과 기존 진료를 비교했다.
AI 보조군은 불필요한 고급 심장영상검사 시행률이 28.4%로 대조군(38.4%)보다 낮았고(OR 0.64, p=0.030), 환자당 비용도 122.5달러 줄었다(p<0.001). 안전성 저하는 관찰되지 않았다.</p>
◆진료 현장에서 LLM 활용법 5가지
배 교수는 실제 진료에서 LLM을 적용할 수 있는 5가지 영역을 구체적으로 제시했다.
▲감별진단 보조(놓치기 쉬운 후보질환까지 목록화) ▲위험도 계층화·계산(ASCVD, SCORE2 등 위험도 점수의 계산과 해석) ▲약물·상호작용·용량 점검(다약제 복용 환자의 신기능에 따른 용량 조정 점검) ▲검사결과·가이드라인 근거 확인(최신 권고안을 출처와 함께 확인) ▲기록·회신 요약(긴 진료기록에서 핵심만 추출) 등이다.
이는 진단 자체를 대체하기보다 임상의의 업무 부담을 줄이고 근거 확인 속도를 높이는 보조도구로 LLM을 활용하는 방식이다.
배 교수는 “머신러닝에서 LLM으로 이어지는 흐름이 심혈관 위험도를 기존 공식 수준으로 계층화하고, 복잡한 진단 사례에서 인간 능력을 넘어서며, 무작위 연구에서 불필요한 저가치 검사를 줄이는 데까지 나아갔다”고 정리했다.
이어 “이제 관건은 AI의 예측 가능 여부가 아니라 장기 임상결과 검증, 보정·공정성 확보, 실제 진료 현장으로의 안전한 통합”이라고 강조했다.
[메디컬월드뉴스 김영신 기자]
 [치과에 대한 모든 것]임플란트부터 턱관절까지…정밀 진단 중요
 [산부인과 제대로 알기]기침∙웃음에 소변 샌다면 ‘여성 요실금’ 의심…정확한 진단이 우선
 [모발이식 제대로 알기]모발이식 결과는 무엇이 좌우할까…모낭 취급부터 수술 후 관리까지
 [피부과 시술 제대로 알기]어깨 필러, 무조건 많은 용량이 좋은 것이 아닌 이유는?
 [성형외과 수술 제대로 알기]가슴성형, 체형별 가슴 볼륨 및 상체라인 설계 중요